Construim stratul de date suveran pentru AI
Pregătim datele enterprise pentru AI, guvernate și gata de folosit.
Le păstrezi suverane când ai nevoie și îți rulezi AI-ul oriunde alegi.
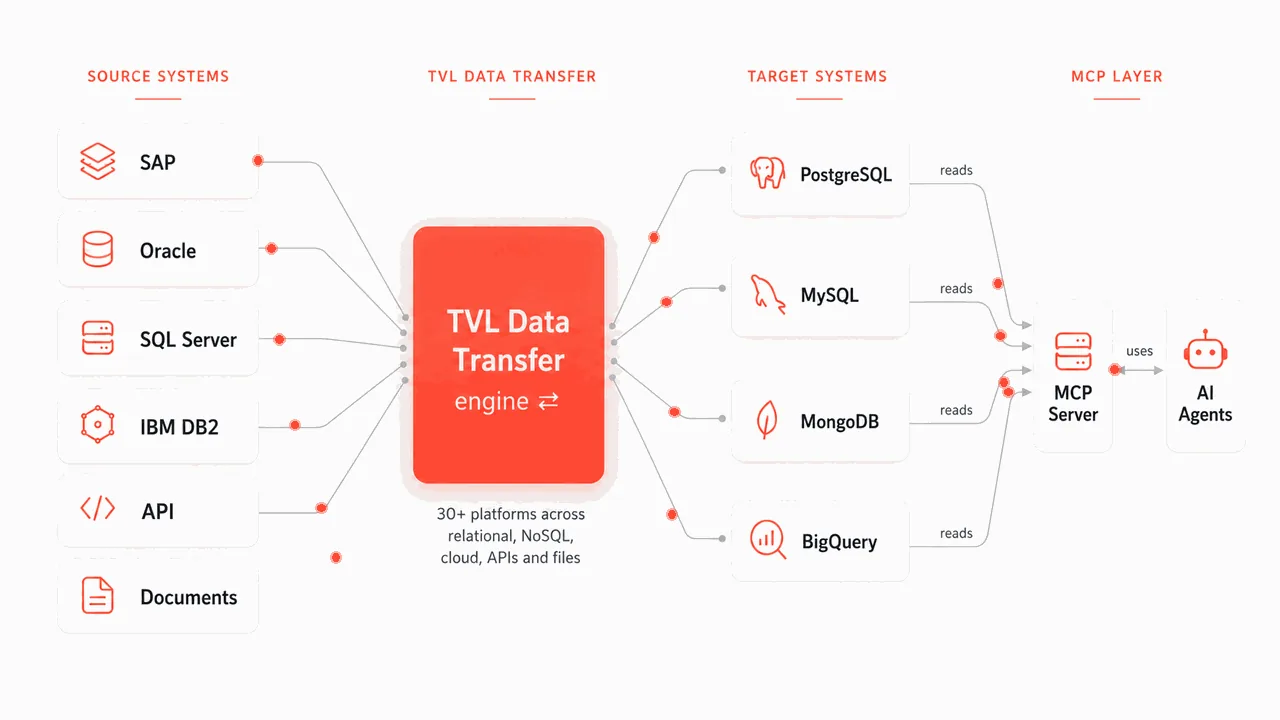
AI-ul are nevoie de datele tale. Tu stabilești regulile.
Datele sunt împrăștiate în SAP, Oracle, Postgres, lacuri de date și fișiere. Fiecare sistem este un siloz, brut și inconsistent, așa că agenții tăi nu se pot baza pe ele în siguranță.
Datele tale sunt peste tot, în zeci de sisteme care nu au fost gândite să comunice între ele.
Ajung brute și inconsistente, așa că agenții construiți pe ele produc răspunsuri în care nu poți avea încredere.
Unde stau datele și unde rulează AI-ul rămâne decizia ta, fără lock in impus de vendor.
EU AI Act și GDPR cer rezidență, auditabilitate și lineage pe care le poți dovedi.
Suverane atunci când ai nevoie
Suveranitatea este o alegere pe care o arhitecturezi. Construim pentru rezidența datelor în UE sau on premise, sub cheile și jurisdicția ta, aliniate la EU AI Act, GDPR și Gaia-X.
Tu alegi unde stau datele
Regiuni UE, on premise, air gapped sau cloud-ul tău. Arhitectura ta și decizia ta, niciodată forțate în estate-ul unui singur vendor.
Tu deții cheile
Pipeline-ul rulează pe infrastructură pe care o controlezi, în jurisdicția ta, cu cheile de criptare în mâinile tale. Noi îl operăm; datele și cheile rămân ale tale.
Auditabil, cap la cap
Fiecare pas este logat și inspectabil, pentru lineage complet, de la înregistrarea din sursă până la răspunsul dat de un agent.
Captează, direcționează și livrează, în ordinea corectă
Un pipeline de change data capture care nu îți rescrie aplicațiile și nu scanează tabele întregi.
Captează
Fiecare insert, update și delete este preluat în momentul commit-ului. Citește din change stream (log based sau trigger based, cum se potrivește) în loc să scaneze tabele întregi, și nu îți rescrie aplicațiile.
Direcționează
Reguli decid ce merge unde: după tabel, coloană, rând sau logică proprie. Din zbor, datele sunt filtrate, mapate, mascate, îmbogățite și divizate sau combinate, cu lookup-uri SQL și reguli scriptate, astfel încât fiecare target primește exact forma de care are nevoie.
Livrează
Modificările sunt grupate în canale, puse în batch-uri comprimate, apoi aplicate în ordine tranzacțională corectă. Traficul este limitat ca să protejeze rețeaua, iar fiecare batch este urmărit, astfel încât livrarea reia exact de unde s-a oprit după o întrerupere.
SAP, Oracle și SQL Server în data lake-ul sau warehouse-ul tău
Aduci datele în target-ul pe care îl alegi: un data lake, o bază de date sau un warehouse precum BigQuery, Postgres, MySQL, Oracle, Splunk sau Elasticsearch. Change data capture face o încărcare curată a istoricului, apoi un flux live aproape în timp real, cât timp sistemele sursă rulează în continuare.
Captură log based sau trigger based, cum se potrivește sursei.
Modelul tău ajunge cu chei, tipuri și relații intacte.
Un backfill curat, apoi un flux live de modificări peste el.
Pregătite pentru raportare și pentru agenții tăi AI, chiar acolo unde lucrezi deja.
Arhitectură medallion, de la captura brută la tabele pregătite pentru business
Fiecare strat trăiește în target-ul tău, versionat și auditabil.
Brut, așa cum ajunge
Fiecare înregistrare din sursă capturată exact cum sosește, fără pierderi. Înregistrarea imuabilă a ceea ce s-a întâmplat.
Curățat și conformat
Deduplicat, tipizat și unit într-un model consistent, peste toate sistemele sursă.
Pregătit pentru business
Tabele agregate și modelate care alimentează raportarea și răspunsurile pe care le dau agenții tăi AI.
Construit pentru estate-uri complexe, din lumea reală
Control la nivel de tabel: sincronizezi un tabel într-o direcție și altul în ambele, în același pipeline. Alegi coloanele, rândurile și direcția per tabel.
Se conectează la sistemele pe care le folosești deja
Citește și scrie în platformele de care depinde business-ul tău, din relational, NoSQL, cloud, fișiere și API-uri.
Fiecare batch urmărit, fiecare rând livrat
Throughput maxim susținut
Măsurat pe deployment-ul nostru de referință, rulând continuu sub sarcină de producție.
Durabil implicit
Fiecare batch este urmărit într-o tranzacție și reîncercat prin întreruperi, așa că livrarea reia exact de unde s-a oprit, fără nimic pierdut.
Scalează orizontal
Canale paralele și noduri în cluster mută datele rapid, cu deployment-uri dovedite pe mii de noduri.
Agenți care răspund din date în care ai încredere
Printr-un server MCP, agenții tăi interoghează stratul Gold guvernat: date curate, pregătite pentru business, pe care agenții se pot baza, așa că răspunsurile rămân de încredere și trasabile. Îi rulezi în SUA, în UE sau on premise.
Răspund peste toate sistemele
Agenții răspund pe înregistrări reale și actuale, unificate din fiecare sursă.
Redactează oferte, atribuie coduri SAP
Redactează oferte și atribuie coduri SAP direct din datele pregătite, muncă ce cerea cândva un specialist.
Fiecare răspuns este trasabil
Răspunsuri guvernate care se trasează înapoi la date reale, pregătite și auditabile, oriunde rulează AI-ul tău.
Aceeași sarcină, făcută în trei feluri
Stack in house sau open source
Control total, dar lent de construit și fragil de operat. Asamblezi singur cititoarele de log, message bus-ul și conectorii de destinație, iar sincronizarea bidirecțională, rezolvarea conflictelor și lineage-ul rămân toate în sarcina ta.
Serviciu într-un singur cloud
Rapid de lansat, apoi greu de părăsit: te leagă de un singur cloud și un singur estate. De obicei unidirecțional, sărac la transformări și deseori orb la surse SAP, Oracle și mainframe. Datele și cheile tale stau în control plane-ul vendorului.
Din orice sursă către orice target
Inclusiv SAP, Oracle și DB2, bidirecțional, găzduit în UE sau on premise, cu cheile tale. Un singur strat aduce datele, le rafinează în Bronze, Silver și Gold și le servește agenților tăi AI, cu lineage auditabil cap la cap.
| Capabilitate | Stack in house / OSS | Serviciu într-un singur cloud | TVL Data Transfer |
|---|---|---|---|
| Găzduire în UE, on premise sau air gapped | Parțial | Nu | Da |
| Chei deținute de client, în jurisdicția ta | Parțial | Nu | Da |
| Surse SAP · Oracle · DB2 | Parțial | Parțial | Da |
| Sincronizare bidirecțională și multi primary | DIY | Nu | Da |
| Transformare, mascare și rutare din zbor | Parțial | Parțial | Da |
| Rafinare Bronze, Silver și Gold | Parțial | Parțial | Da |
| Gold guvernat servit agenților AI (MCP) | Nu | Emergent | Da |
| Lineage auditabil, cap la cap | Parțial | Parțial | Da |
Dovedit pentru Comisia Europeană
EBSI, pentru Comisia Europeană
CTO-ul nostru a proiectat și auditat smart contract-urile din spatele European Blockchain Services Infrastructure (EBSI) al UE.
Scală enterprise
CEO-ul nostru a scalat eMAG Marketplace la 1 miliard $ ARR și face parte din AI Group of Practice al Comisiei Europene.
De încredere & recunoscuți
De încredere pentru DataDiggers. Mentor și jurat NATO DIANA. O echipă senior, internațională, în Luxemburg, România și SUA.
De la două sisteme la un pipeline live, în săptămâni
Delimităm, construim și operăm pipeline-ul cap la cap, pe datele tale.
Delimităm
Mapăm cele două sisteme, tabelele care contează și forma de care are nevoie fiecare target. Primești un plan clar înainte să construim ceva.
Construim
Ridicăm pipeline-ul pe datele tale: captură, rutare și rafinare, cu o încărcare curată a istoricului și un flux live peste el.
Operăm
Îl rulăm cap la cap, cu monitorizare, retry automat și lineage auditabil, ca să livreze constant pe măsură ce estate-ul tău se schimbă.
O migrare, sau o coloană vertebrală de date live
Începe mic și crește, sau ne dai tot. Trei feluri de a lucra împreună.
Pilot delimitat
O dovadă cu scop fix, pe datele tale, ca să vezi cum funcționează înainte să te angajezi la mai mult.
Contract-cadru
Un cadru agreat pentru a extinde pipeline-ul peste sisteme și echipe, pe măsură ce crești.
Serviciu administrat
Operăm pipeline-ul pentru tine, cap la cap, ca serviciu administrat continuu.
Întrebările pe care le primim cel mai des
Hai să-ți mutăm datele
Spune-ne cele două sisteme. Ridicăm un pipeline funcțional pe datele tale în săptămâni, nu trimestre, ca pilot delimitat, contract-cadru sau serviciu administrat.
Programează o discuție de 30 de minute. Spune-ne cele două sisteme și ne ocupăm noi de rest.
Preferi email? Scrie-ne la